Google nie widzi strony - przyczyny i diagnoza krok po kroku
Google nie widzi strony? Sprawdź, czy problem leży w skanowaniu, indeksowaniu czy wynikach, co oznaczają statusy Search Console i jak to naprawić.
- AK
Autor: Artur Kacprzak
- 10 min czytania
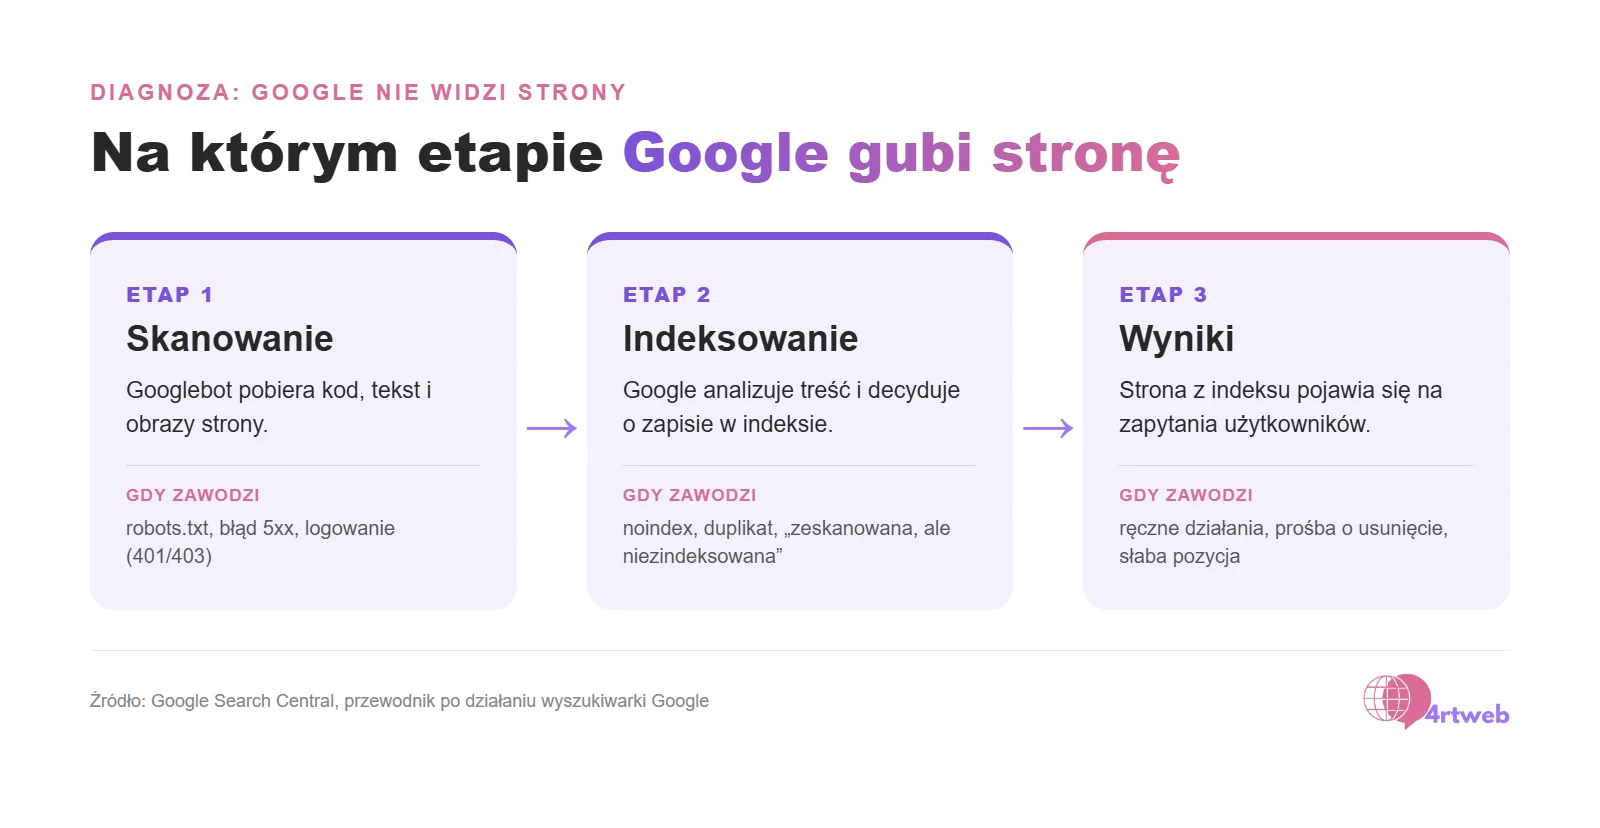
Gdy Google nie widzi strony, problem leży na jednym z 3 etapów pracy wyszukiwarki. Googlebot nie może jej zeskanować, Google zeskanował ją, ale nie dodał do indeksu, albo strona jest w indeksie, lecz nie wyświetla się na Twoje zapytanie. Etap sprawdzisz operatorem site:twojadomena.pl i Narzędziem do sprawdzania adresów URL w Google Search Console. Prośbę o zindeksowanie Google obsługuje zwykle w ciągu jednego dnia, wykrycie nowej witryny może zająć kilka tygodni, a konkretnego terminu indeksowania Google nie podaje.
Jak sprawdzić, czy Google widzi stronę
Sprawdzenie, czy Google widzi stronę, zaczyna się od wpisania w wyszukiwarkę site:twojadomena.pl. Jeśli wyniki są puste, Google nie ma w indeksie żadnego adresu z Twojej domeny. Jeśli pojawia się część podstron, problem dotyczy konkretnych adresów, a nie całej witryny. Operator site: nie zawsze pokazuje wszystkie zindeksowane adresy, dlatego traktuj go jako pierwszy sygnał, a nie ostateczny wynik.
Drugi krok to Google Search Console - narzędzie Google, które pokazuje błędy blokujące roboty i stan indeksowania podstron. Po dodaniu i zweryfikowaniu domeny:
- Wklej adres podstrony w polu Narzędzia do sprawdzania adresów URL na górze panelu.
- Odczytaj status - narzędzie pokaże, czy adres jest w indeksie, a jeśli nie, poda powód.
- Kliknij Sprawdź URL wersji opublikowanej, żeby przetestować aktualną wersję strony. Zrzut ekranu tego, co zobaczył Googlebot, znajdziesz w zakładce Wyświetl przetestowaną stronę.
Trzeci test: otwórz stronę w oknie incognito w Chrome. Jeśli wymaga logowania albo pokazuje błąd, Googlebot widzi to samo i nie pobierze treści.
Ta kolejność pokazuje, na którym etapie Google nie widzi strony: skanowania, indeksowania czy wyników. Jeśli Google nie widzi strony już w teście site:, zacznij od przyczyn na etapie skanowania.
Dlaczego Google nie widzi mojej strony - przegląd przyczyn
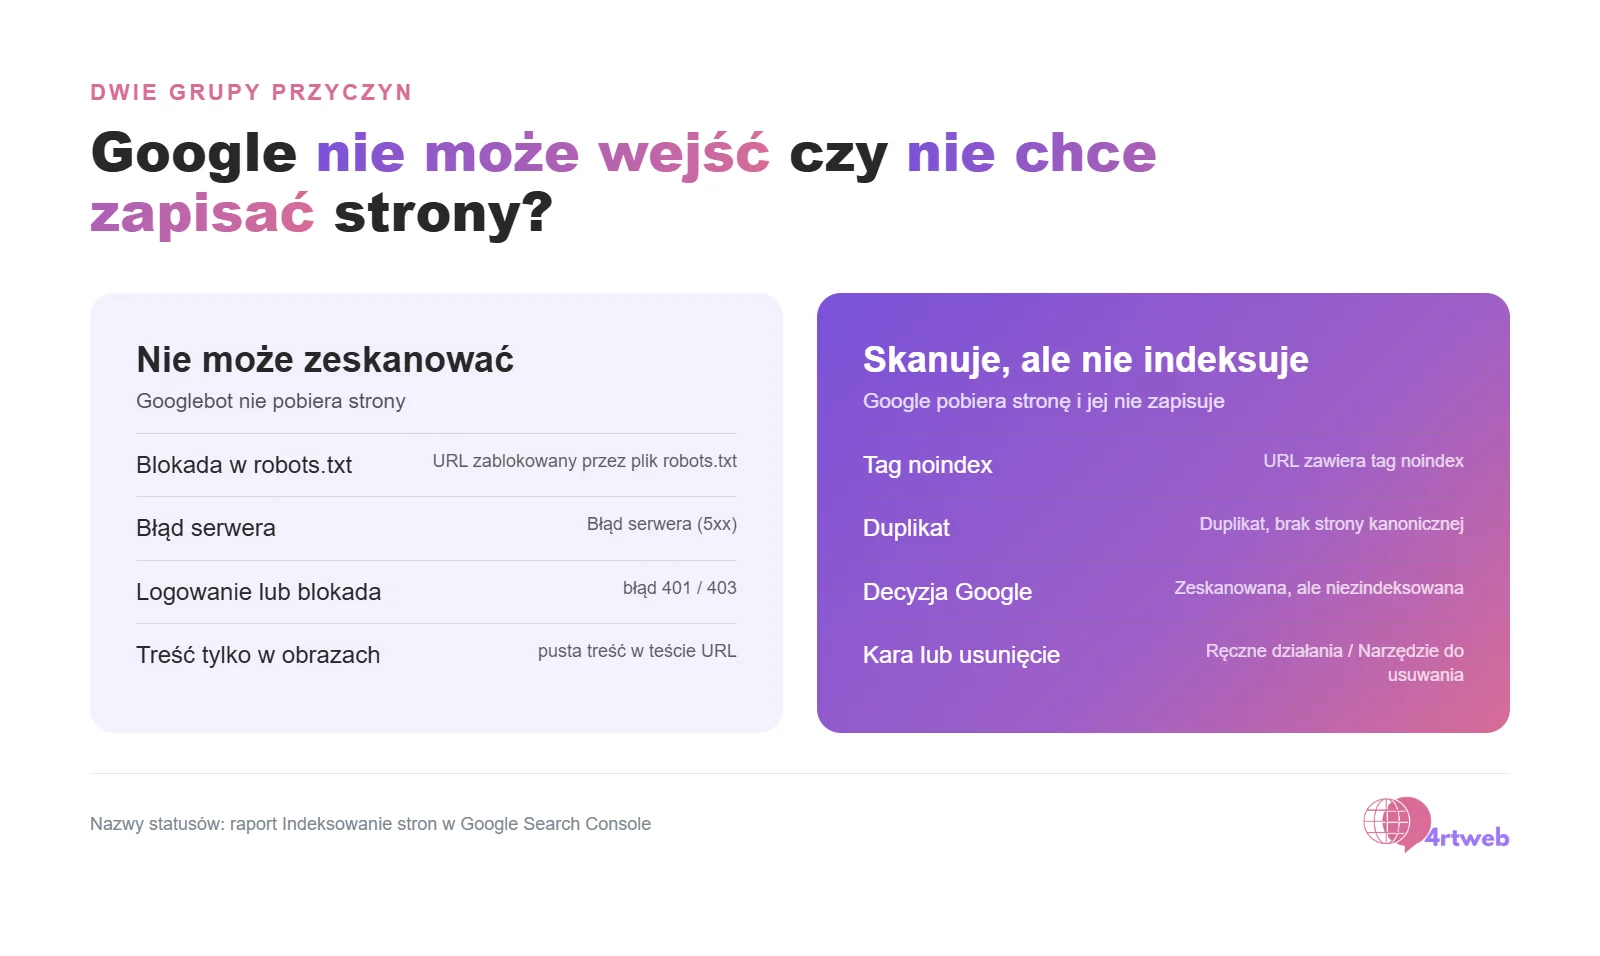
Google nie widzi Twojej strony z jednej z dwóch grup powodów: robot nie może jej pobrać albo pobiera ją, ale nie zapisuje w indeksie. Trzecia, osobna sytuacja to strona, która była w Google i nagle zniknęła z wyników. Przegląd przyczyn według etapu:
| Etap | Przyczyna | Objaw w Search Console |
|---|---|---|
| skanowanie | nowa witryna bez linków z innych stron | adres nieznany Google (brak w raporcie Indeksowanie stron) |
| skanowanie | blokada w pliku robots.txt | URL zablokowany przez plik robots.txt |
| skanowanie | błąd serwera | Błąd serwera (5xx) |
| skanowanie | logowanie lub blokada dostępu | błąd 401 lub 403 |
| skanowanie | treść tylko w obrazach lub filmach | pusty zrzut w teście wersji opublikowanej |
| indeksowanie | tag noindex | URL zawiera tag noindex |
| indeksowanie | duplikat bez strony kanonicznej | Duplikat, użytkownik nie oznaczył strony kanonicznej |
| indeksowanie | decyzja Google o jakości | Strona zeskanowana, ale jeszcze niezindeksowana |
| wyniki | ręczne działania | raport Ręczne działania |
| wyniki | prośba o usunięcie | wpis w Narzędziu do usuwania |
Gdy Google nie widzi strony nowo postawionej, najpierw sprawdź pierwszą i szóstą pozycję tabeli - brak linków i tag noindex. Gdy strona zniknęła nagle, zacznij od ostatnich dwóch.
Google nie widzi strony, bo nie może jej zeskanować
Google nie widzi strony na etapie skanowania, gdy Googlebot nie może jej znaleźć albo pobrać. Skanowanie to pierwszy z 3 etapów: robot pobiera tekst, obrazy i kod strony. Jeśli ten etap się nie uda, Google nie pozna treści strony - choć adres zablokowany w robots.txt może trafić do indeksu z linków. Dokumentacja Google wymienia 4 źródła blokad: problemy z serwerem, problemy z siecią, reguły w pliku robots.txt i strony wymagające zalogowania.
Przyczyna 1: nowa witryna bez linków z innych stron
Nowa witryna potrzebuje czasu, bo wykrycie nowej witryny lub zmian w istniejącej może zająć Google kilka tygodni. Brak linków z innych stron to jedna z przyczyn, które Google wymienia wprost. Bez nich robot może też przeoczyć mniejszą witrynę.
Przyczyna 2: blokada w pliku robots.txt
Reguła Disallow w pliku robots.txt zabrania Googlebotowi wejścia na stronę lub cały katalog. W Search Console taka strona ma status „URL zablokowany przez plik robots.txt”. Blokada skanowania nie wyklucza indeksowania na podstawie linków z innych stron, więc adres może pojawić się w wynikach bez opisu.
Przyczyna 3: błędy serwera
Błąd serwera 5xx odcina Googlebota od treści strony. W raporcie zobaczysz wtedy status „Błąd serwera (5xx)”.
Przyczyna 4: logowanie i blokady dostępu
Logowanie blokuje dostęp Googlebotowi, bo robot nie podaje hasła. Strona za hasłem zwraca mu błąd 401, a serwer odrzucający robota - błąd 403. W Search Console zobaczysz status „Strona zablokowana z powodu nieautoryzowanego żądania (401)” albo „Strona zablokowana z powodu zabronionego dostępu (403)”.
Przyczyna 5: treść niedostępna dla robotów
Treść niedostępna dla robotów to tekst zapisany wyłącznie w obrazach albo filmach bez opisu. Google renderuje strony i uruchamia JavaScript w najnowszej wersji Chrome, ale z samych obrazów nie odczyta treści do zindeksowania. To samo dotyczy technologii innych niż HTML.
Gdy Google nie widzi strony z powodu skanowania, po poprawce sprawdź adres ponownie testem wersji opublikowanej w Narzędziu do sprawdzania adresów URL.
Google nie indeksuje strony, choć ją zeskanował
Google nie indeksuje strony, choć ją zeskanował, gdy robot pobrał treść, a potem uznał, że nie powinna trafić do indeksu. Indeksowanie nie jest gwarantowane: Google nie zapisuje każdej przetworzonej strony. Przyczyny dzielą się na ustawienia, które sam przesyłasz robotowi, i decyzje Google.
Przyczyna 6: tag noindex
Tag noindex każe Google usunąć stronę z wyników. Zapisuje się go jako <meta name="robots" content="noindex"> w sekcji head albo jako nagłówek HTTP X-Robots-Tag: noindex. W WordPressie ten sam efekt daje zaznaczone pole w Ustawienia > Czytanie > Widoczność dla wyszukiwarek. Pułapka: jeśli strona z noindex jest jednocześnie zablokowana w robots.txt, Googlebot nie zobaczy dyrektywy. Google nie obsługuje też noindex wpisanego w robots.txt.
Przyczyna 7: duplikaty i strona kanoniczna
Duplikaty sprawiają, że Google grupuje podobne strony w klaster i w wynikach pokazuje jedną - kanoniczną. Pozostałe adresy dostają status „Duplikat, użytkownik nie oznaczył strony kanonicznej”. Rozwiązaniem jest wskazanie wersji preferowanej, a przy kilku wersjach domeny przekierowanie 301 na jedną z nich. Przekierowanie 301 przenosi sygnały, np. linki.
Przyczyna 8: strona zeskanowana, ale jeszcze niezindeksowana
Status „Strona zeskanowana, ale jeszcze niezindeksowana” oznacza, że Googlebot odwiedził stronę, ale Google nie dodał jej do indeksu. Według Google ponowne zgłaszanie nie jest potrzebne, a strona może trafić do indeksu później. Gary Illyes z Google wskazuje jako przyczyny jakość witryny i podobieństwo treści do stron już zaindeksowanych, dlatego zacznij od poprawy jakości i unikalności treści tej podstrony.
Strona zniknęła z Google - ręczne działania i prośba o usunięcie
Google nie widzi strony, która wcześniej była w wynikach, gdy trafiła pod ręczne działania albo prośbę o usunięcie. Obie przyczyny dotyczą adresów, które były już w indeksie, więc diagnoza zaczyna się w innych raportach niż przy nowej stronie.
Przyczyna 9: ręczne działania
Ręczne działania to kara nałożona przez pracownika Google po naruszeniu zasad dotyczących spamu - strony mogą wtedy spaść lub zniknąć z wyników. Informację znajdziesz w raporcie Ręczne działania w Search Console. Żeby odzyskać widoczność, popraw wszystkie wskazane strony i kliknij Poproś o sprawdzenie. Rozpatrzenie trwa od kilku dni do kilku tygodni.
Przyczyna 10: prośba o usunięcie
Prośba o usunięcie wysłana w Narzędziu do usuwania w Search Console może zablokować całą witrynę - wystarczy jedna. Prośbę można anulować w tym samym narzędziu.
Gdy Google nie widzi strony, która wcześniej była w wynikach, sprawdź też tag noindex dodany przy ostatniej aktualizacji strony.
Statusy w raporcie Indeksowanie stron
Raport Indeksowanie stron w Google Search Console podaje dla każdego niezindeksowanego adresu konkretny powód. Status od razu wskazuje etap, na którym Google nie widzi strony. Statusy, które wyjaśniają, dlaczego Google nie widzi strony:
| Status w Search Console | Co oznacza | Co zrobić |
|---|---|---|
| Strona wykryta - obecnie niezindeksowana | Google zna adres, ale go nie zeskanował, np. by nie przeciążyć serwera | sprawdź wydajność serwera |
| Strona zeskanowana, ale jeszcze niezindeksowana | Googlebot był na stronie, ale nie dodał jej do indeksu | popraw jakość i unikalność treści |
| URL zawiera tag noindex | strona sama blokuje indeksowanie | usuń noindex, jeśli strona ma być w wynikach |
| URL zablokowany przez plik robots.txt | reguła w robots.txt blokuje skanowanie | popraw regułę w robots.txt |
| Duplikat, użytkownik nie oznaczył strony kanonicznej | Google wybrał inny adres jako kanoniczny | wskaż stronę kanoniczną lub ustaw przekierowanie 301 |
| Nie znaleziono (404) | adres nie istnieje | przy przeniesionej treści ustaw przekierowanie 301 |
| Pozorny błąd 404 | strona wygląda na pustą, ale zwraca kod sukcesu | dodaj treść albo zwróć kod 404 |
| Błąd serwera (5xx) | serwer nie oddał strony | sprawdź hosting i logi serwera |
| Błąd przekierowania | przekierowanie nie prowadzi do działającej strony | sprawdź przekierowanie w Narzędziu do sprawdzania adresów URL |
| Strona zablokowana z powodu nieautoryzowanego żądania (401) | strona wymaga logowania | udostępnij stronę bez logowania |
| Strona zablokowana z powodu zabronionego dostępu (403) | serwer odrzuca Googlebota | sprawdź zabezpieczenia serwera |
Statusy dotyczące duplikatów i przekierowań bywają poprawne: jeśli adres celowo przekierowuje na inny, brak go w indeksie to stan oczekiwany. Problem pojawia się wtedy, gdy Google nie widzi strony, która ma zbierać ruch, np. strony usługi czy wpisu na blogu.
Co zrobić, żeby Google znalazł stronę
Gdy Google nie widzi strony, usuń blokady wykryte w diagnozie, a potem wskaż robotowi adresy na trzy sposoby: mapą witryny, prośbą o zindeksowanie i linkami. Google nie przyjmuje opłat za częstsze indeksowanie ani za pozycję.
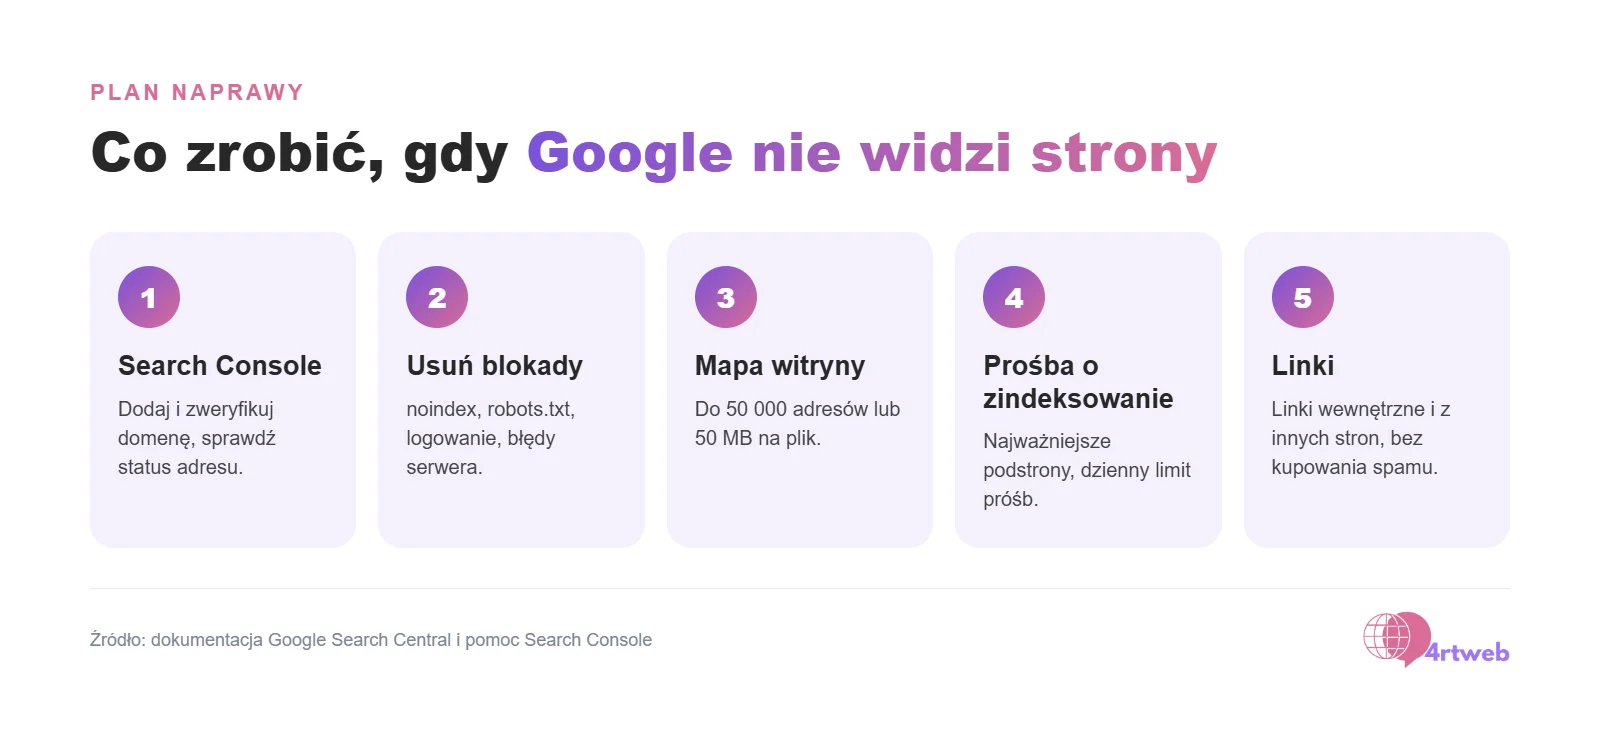
- Dodaj stronę do Google Search Console i zweryfikuj domenę. Bez tego nie zobaczysz statusów indeksowania.
- Usuń blokady: noindex, reguły w robots.txt, wymóg logowania, błędy serwera. W WordPressie odznacz pole w Ustawienia > Czytanie > Widoczność dla wyszukiwarek.
- Prześlij mapę witryny w raporcie Mapy witryn albo dopisz linię Sitemap: w robots.txt. Jeden plik mapy może mieć maksymalnie 50 MB lub 50 000 adresów URL. Mapa witryny to tylko wskazówka dla Google, a nie obietnica zindeksowania czy wyższej pozycji.
- Poproś o zindeksowanie najważniejszych podstron w Narzędziu do sprawdzania adresów URL. Obowiązuje dzienny limit próśb, dlatego przy wielu adresach lepsza jest mapa witryny.
- Zdobądź linki z innych stron i podlinkuj nowe podstrony wewnętrznie. Nie płać za linki - Google może uznać to za spam.
Po wprowadzeniu poprawek wróć do raportu Indeksowanie stron i sprawdź, czy liczba niezindeksowanych adresów spada. Gdy Google nie widzi strony mimo wszystkich kroków, sprawdź, czy adres ma status „Strona zeskanowana, ale jeszcze niezindeksowana” - wtedy według Google decyduje jakość witryny i podobieństwo treści.
Ile trwa indeksowanie strony w Google
Gdy Google nie widzi nowej strony, czas do indeksowania zależy od wykrycia - Google nie podaje konkretnego terminu. Google zwykle obsługuje prośbę z Narzędzia do sprawdzania adresów URL w ciągu jednego dnia, ale może to potrwać dłużej. Wykrycie nowej witryny lub zmian w istniejącej może zająć Google kilka tygodni.
Czas zależy od tego, jak łatwo robot trafia na stronę. Nowa witryna bez linków z innych stron może czekać na wykrycie kilka tygodni. Mapa witryny i prośba o zindeksowanie wskazują adresy, ale nie skracają tego czasu w sposób, który Google by obiecywał.
Działa to też w drugą stronę: strona usunięta z serwisu może zostać w wynikach nawet miesiącami, dopóki Googlebot jej ponownie nie zeskanuje.
Jeśli po kilku tygodniach Google nadal nie widzi strony, wróć do diagnozy i sprawdź status w Search Console zamiast ponownie wysyłać te same prośby. Przy statusie „Strona zeskanowana, ale jeszcze niezindeksowana” ponowne zgłaszanie nie jest potrzebne, a według Google na ten status wpływają jakość witryny i podobieństwo treści do innych stron.
FAQ
Czy można zapłacić Google, gdy Google nie widzi strony?
Zapłacić Google za szybsze indeksowanie nie można. Google nie przyjmuje opłat za częstsze indeksowanie stron ani za pozycję w wynikach.
Czy mapa witryny wystarczy, gdy Google nie indeksuje strony?
Mapa witryny nie wystarczy, gdy Google nie indeksuje strony. Pomaga Google poznać adresy, ale według dokumentacji jest tylko wskazówką - nie przesądza o zindeksowaniu ani o wyższej pozycji.
Strona jest w indeksie, ale nie widać jej na frazę - dlaczego?
Strona w indeksie, której nie widać na frazę, ma problem na etapie wyników, a nie indeksowania. Sprawdź najpierw kanonizację: Google grupuje podobne strony i w wynikach pokazuje tylko stronę kanoniczną, więc na frazę może wyświetlać się inny adres z Twojej domeny. Jeśli adres jest kanoniczny i zindeksowany, to temat pozycjonowania.
Dlaczego Google indeksuje stronę zablokowaną w robots.txt?
Blokada w robots.txt zabrania skanowania, ale nie indeksowania. Jeśli inne strony linkują do adresu, Google może go zindeksować bez treści. Żeby usunąć stronę z wyników, użyj noindex i zdejmij blokadę w robots.txt.
Diagnoza indeksowania w audycie SEO
Gdy Google nie widzi strony, diagnozę indeksowania robimy w ramach audytu SEO. Artur Kacprzak, który prowadzi 4rtweb, zajmuje się SEO od 2015 roku. Zakres i cennik znajdziesz na stronie Audyt SEO. Napisz na artur@4rtweb.pl albo zadzwoń: 500 291 418.
Źródła
- Szczegółowy przewodnik po działaniu wyszukiwarki Google
- Wyświetlanie swojej witryny w Google
- Najczęstsze pytania o indeksowanie i skanowanie
- Tworzenie i przesyłanie mapy witryny
- Blokowanie indeksowania za pomocą noindex
- Raport Indeksowanie stron - pomoc Search Console
- Narzędzie do sprawdzania adresów URL
- Raport Ręczne działania
- Google wyjaśnia przyczyny statusu „zeskanowana, ale niezindeksowana” - Ranktracker
- Dlaczego witryna WordPress zniknęła z Google - WPBeginner
Oceń artykuł
Czy ten artykuł był pomocny?
Oceń jako pierwsza osoba

Autor artykułu
Specjalista SEO, założyciel · 4rtweb
Zajmuje się pozycjonowaniem stron i sklepów, widocznością w odpowiedziach AI, kampaniami Google Ads oraz tworzeniem stron WordPress. W SEO od 2015 roku, biuro w Warszawie.
Dyskusja
Komentarze
Nie ma jeszcze komentarzy. Masz pytanie do artykułu? Napisz je poniżej.